 3分鐘研究室
在 YouTube「3分鐘研究室」看影片約三分鐘講完這篇論文,開新頁到 YouTube
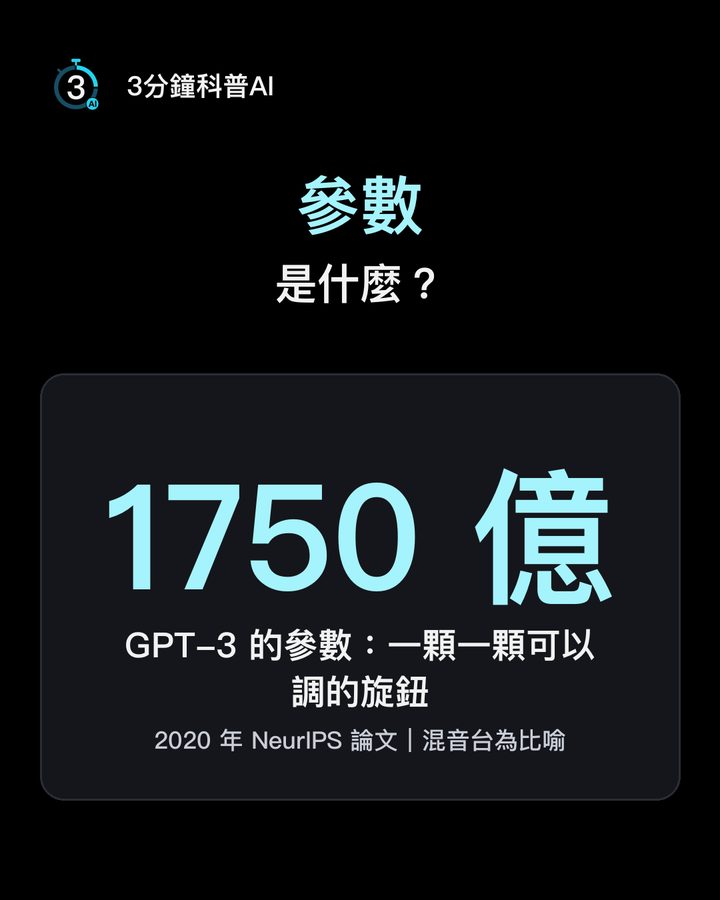
GPT-3 這個 AI 裡面,有 1750 億顆可以轉的旋鈕。這些旋鈕,就叫參數。上一篇說,每個字都會變出 Q、K、V 三份;怎麼變,就是這些旋鈕決定的。
論文怎麼做
- 參數是什麼: 想像一台超大的混音台,每一顆旋鈕轉一點點,聲音就變一點點。模型裡的參數,就是這樣一個一個可以調整的數字。把字變成 Q、K、V 的轉換裡面裝滿了參數;這是其中一處,模型裡還有很多地方也裝滿旋鈕。
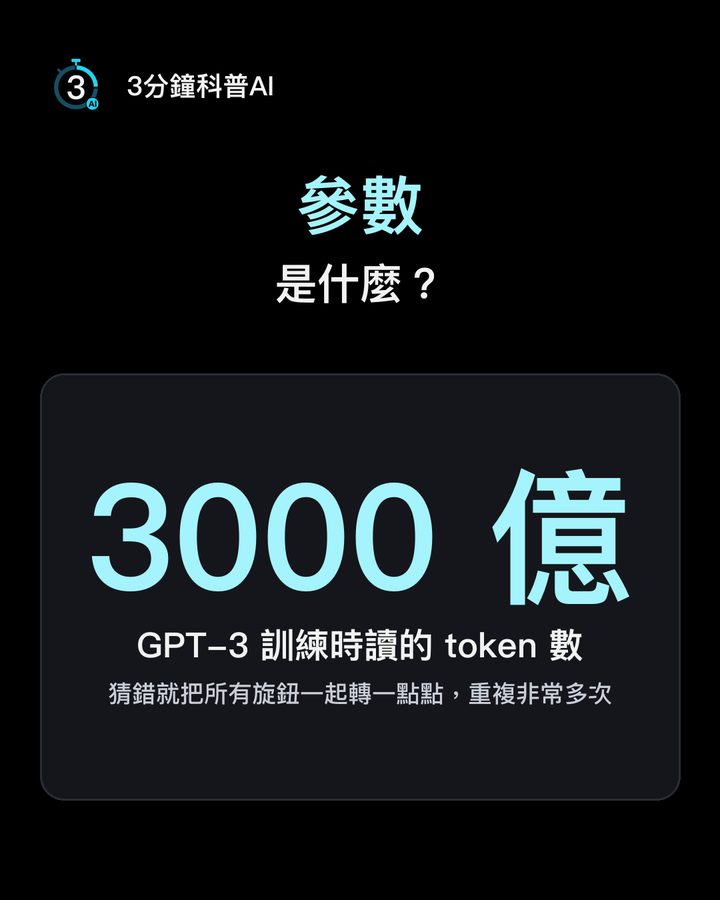
- 怎麼訓練: 一開始旋鈕都是隨便轉的,模型基本上在亂猜。訓練就是讓它讀大量文字、猜下一個字;猜錯了,就把所有旋鈕一起往比較會猜對的方向轉一點點,重複非常多次。GPT-3 在訓練時一共讀了 3000 億個 token(模型讀文字的小單位,一個中文字也常被切成好幾個 token)。
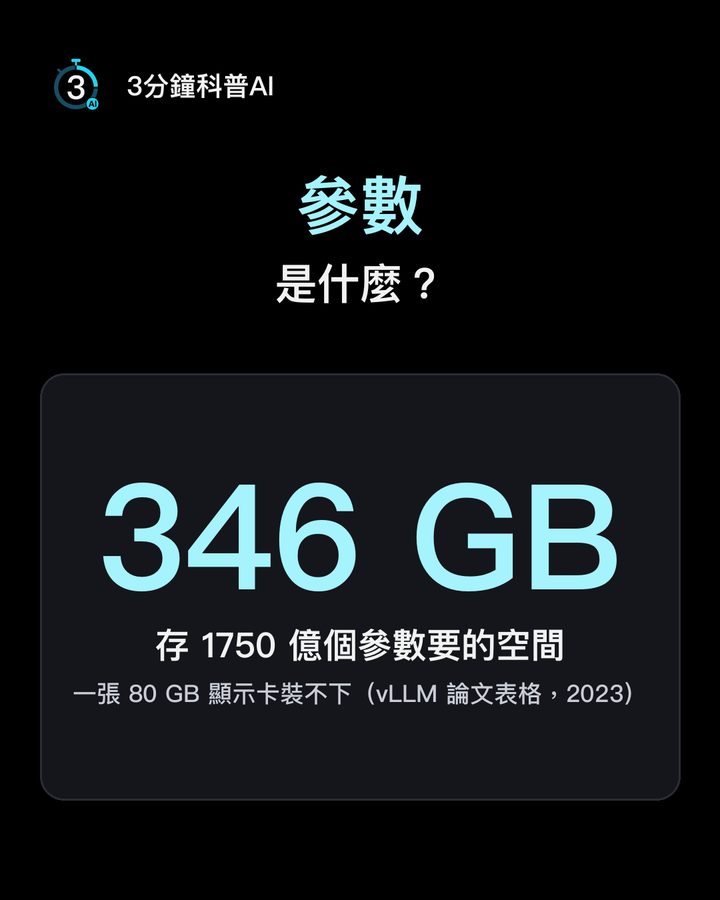
- 有多大: 2017 年 Transformer 論文的大型版約 2 億 1300 萬個參數;2020 年的 GPT-3 是 1750 億,大了八百多倍。2023 年一篇論文(vLLM)的表格寫到,光是把 1750 億個參數存起來就要 346 GB,一張 80 GB 的顯示卡根本裝不下,那篇論文用了 8 張來跑。
結果
為什麼要做這麼大?2020 年 OpenAI 的一篇研究發現:模型越大、資料越多、電腦算得越久,錯誤就照著一條很規律的曲線往下降,有些趨勢從最小到最大,規模差了一千萬倍以上,曲線都還成立。這篇是 arXiv 預印本,還沒經過正式審查。
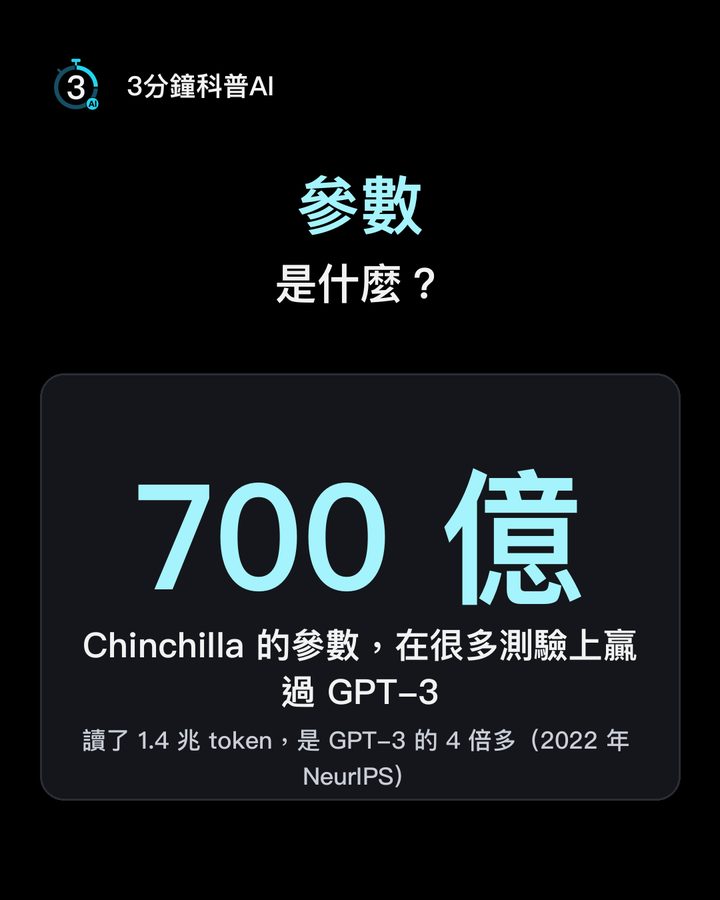
不過,2022 年 DeepMind 的研究提醒:不能光把旋鈕變多。要把算力用得最划算,參數多一倍,訓練資料也該多一倍。他們做的 Chinchilla 有 700 億個參數,不到 GPT-3 的一半,讀的資料卻是 GPT-3 的 4 倍多(1.4 兆對 3000 億 token),在很多測驗上反而贏過 GPT-3。
用三個問題來看
- 它解決了什麼問題? 不用工程師一條一條寫規則,讓模型從大量文字裡,自己把旋鈕調好。
- 今天的 AI 哪裡用到它? 2020 年之後,很多大型語言模型都參考這類規律,決定要做多大、要讀多少資料;Chinchilla 就是拿它重新算帳的例子。
- 它有什麼限制? 參數越多越貴:要更多記憶體才放得下,每回答一個字都要用到這些參數;而且這些規律是從過去的實驗量出來的,不保證一直成立。
記住:參數就是模型裡一顆一顆可以調的旋鈕,GPT-3 有 1750 億顆;訓練就是猜錯一次、全部轉一點點,轉到它越來越會猜。
出處
- Brown, T. B., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://arxiv.org/abs/2005.14165
- Kaplan, J., et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361(預印本). https://arxiv.org/abs/2001.08361
- Hoffmann, J., et al. (2022). An Empirical Analysis of Compute-Optimal Large Language Model Training. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://arxiv.org/abs/2203.15556
- Vaswani, A., et al. (2017). Attention Is All You Need. NIPS 2017. https://arxiv.org/abs/1706.03762
- Kwon, W., et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP 2023, 611–626. https://doi.org/10.1145/3600006.3613165
本文為論文解說,內容經過簡化,方便理解;混音台旋鈕為比喻。