 3分鐘研究室
為什麼跟 AI 聊越久越吃記憶體?一次看懂 KV cache
AI 一次寫一個字,前面每個字的 K 和 V 都記在一本「筆記」上,這本筆記叫 KV cache。它讓生成變快,也讓長對話越來越吃記憶體。
在 YouTube「3分鐘研究室」看影片約三分鐘講完這篇論文,開新頁到 YouTube
你跟 AI 聊得越久,它背後要記的東西就越多:以一個 130 億參數的模型來說,光一段對話,就可能要 1.6 GB。這本越寫越厚的筆記,叫做 KV cache。上一篇說參數存起來就要幾百 GB;這一篇來看聊天時會越長越大的這本筆記。
論文怎麼做
AI 寫答案是一次寫一個 token(可以先想成一個字),寫完一個,再根據前面全部的內容,寫下一個。
- 沒有筆記會怎樣: 想像你在寫作文,規定每寫一個字,都要把前面整篇從頭讀一遍,才能決定下一個字。寫到第一千個字,就得重讀前面九百九十九個字。
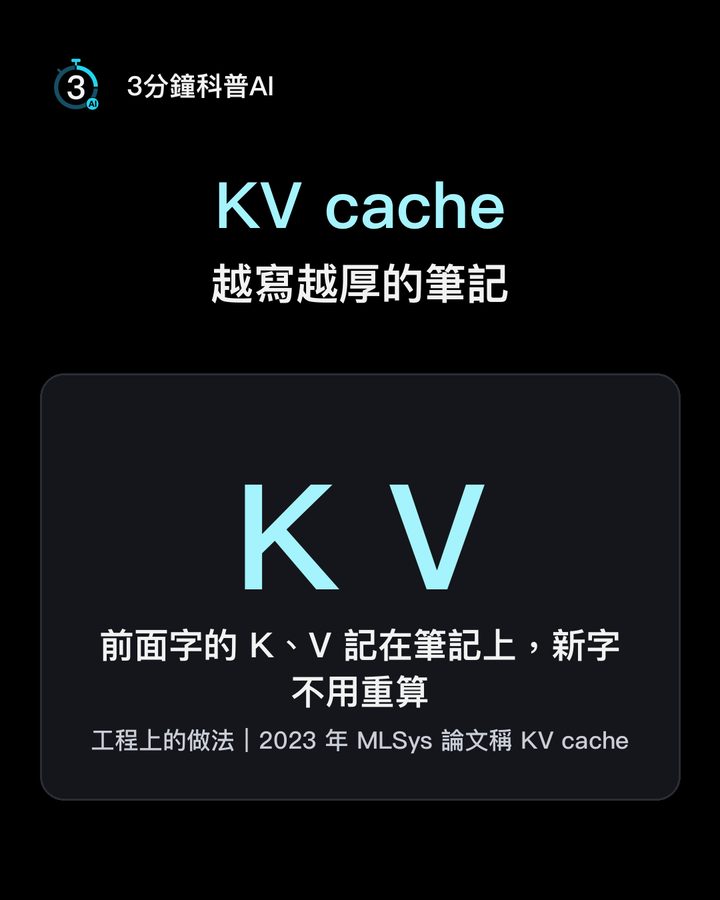
- 筆記怎麼來: 前前一篇說過,每個字都會變出 Q、K、V。前面已經寫好的字,K 和 V 算好了就不會再變。所以工程師把前面每個字的 K 和 V 記在一本筆記上;寫新的字時,算它自己的 Q、K、V,拿 Q 去比對筆記裡的 K,再照分數拿 V。這本筆記,就叫 KV cache。
- 工程做法,不是新理論: 2023 年 Google 在 MLSys 研討會發表的論文,研究大型模型怎麼跑得快,就把每一層的 K 和 V 叫做 KV cache,說它在整個生成過程都要放在記憶體裡。
結果
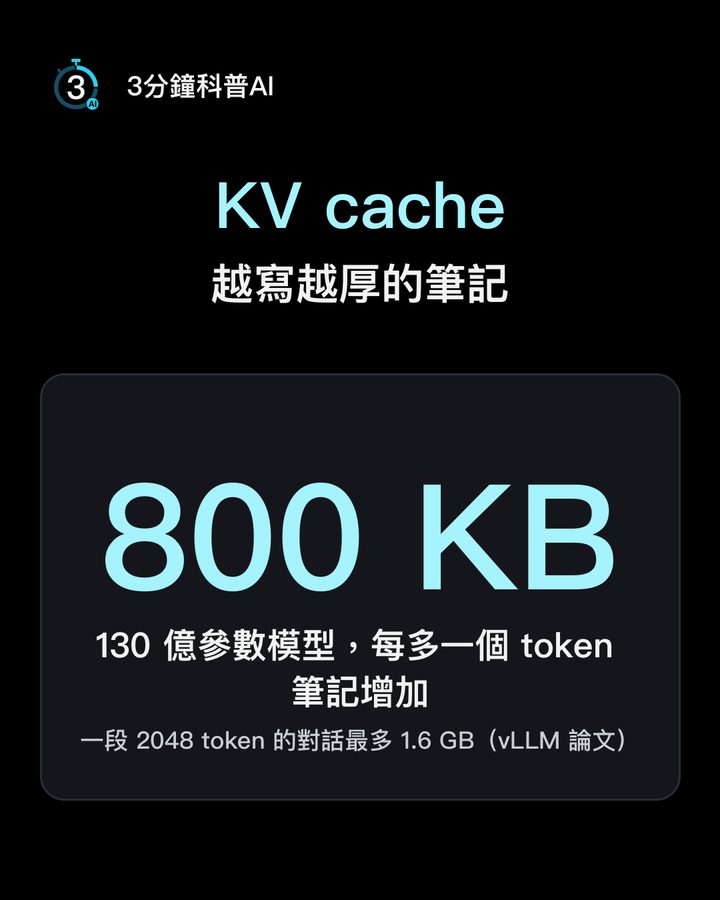
- 筆記越寫越厚: 2023 年 vLLM 的論文算過,一個 130 億參數的模型(OPT-13B),每多一個 token,筆記就多 800 KB;這個模型一段對話最長 2048 個 token,筆記最多就要 1.6 GB。同時有很多人在聊,就是很多本。
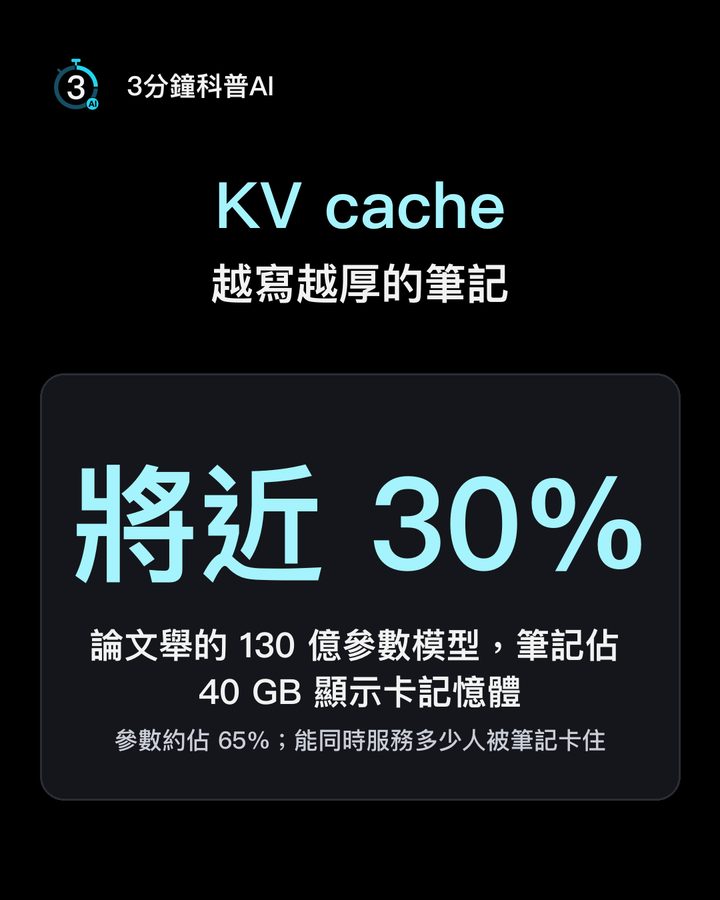
- 記憶體被卡住: 同一篇論文舉了一個 130 億參數的模型,放在一張 40 GB 的顯示卡上,模型參數佔了大約 65%,筆記佔了將近 30%。能同時服務多少人,就被這本筆記卡住。
- 更大的模型更誇張: Google 那篇論文舉了一個假設的例子:五千億個參數以上、用傳統注意力設計的模型,同時處理 512 段、每段 2048 個 token,筆記一共 3 TB,是模型參數本身的 3 倍。
vLLM 的解法,是學電腦作業系統管記憶體的方法:像活頁本,把筆記切成一頁一頁,用完一頁再加一頁,不用一開始就買最厚的那本。論文發現,當時的系統預留給筆記的空間,真正拿來存內容的大約兩到四成;換成新方法後,在回答速度差不多的情況下,每秒能處理的提問變成 2 到 4 倍。
用三個問題來看
- 它解決了什麼問題? 不用每寫一個新字,就把前面所有字的 K 和 V 重算一次,生成快很多。
- 今天的 AI 哪裡用到它? 聊天機器人一個字一個字吐出答案的時候,背後負責產生答案的程式,就靠這本筆記。
- 它有什麼限制? 筆記跟著對話一起變長,很吃記憶體;這也是對話長度有上限、長對話比較貴的原因之一。
AI 寫答案,不用每寫一個字就把前面重算一遍,翻旁邊那本筆記就好;代價是,筆記會越寫越厚。
出處
- Pope, R., Douglas, S., Chowdhery, A., Devlin, J., Bradbury, J., Levskaya, A., Heek, J., Xiao, K., Agrawal, S., & Dean, J. (2023). Efficiently Scaling Transformer Inference. Proceedings of Machine Learning and Systems 5 (MLSys 2023). https://arxiv.org/abs/2211.05102
- Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., & Stoica, I. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP 2023, 611–626. https://doi.org/10.1145/3600006.3613165
本文為論文解說,內容經過簡化,方便理解;寫作文與筆記為比喻。