 3分鐘研究室
沒看過一盤人類棋譜,100 比 0 打敗 AlphaGo:AI 怎麼靠試錯變強
2017 年《自然》期刊的 AlphaGo Zero 沒看過任何人類棋譜,自己跟自己下大約 3 天、490 萬盤,就以 100 比 0 贏過打敗李世乭的 AlphaGo。它靠的是強化學習:不給答案,給分數。從 2015 年 DQN 學打電動講起。
在 YouTube「3分鐘研究室」看影片約三分鐘講完這篇論文,開新頁到 YouTube
一個沒看過任何人類棋譜的圍棋 AI,跟打敗世界冠軍李世乭的 AlphaGo 下了 100 盤,結果是 100 比 0。它從完全亂下開始,自己跟自己下了大約 3 天、490 萬盤。沒有人教,它怎麼變強?靠的是「強化學習」:不給正確答案,等 AI 做完再給分數,讓它自己試錯。
強化學習是什麼
- 像教小狗坐下: 你沒辦法跟牠解釋什麼叫坐下;牠亂動,剛好坐下了,就給一塊零食。幾次之後,牠就學會:坐下,有零食。
- AI 版: AI 做一個動作,環境回給它分數;拿高分的做法多做,拿低分的少做。難的是,分數常常很晚才來,AI 得自己分清楚是哪幾步做對了。
2015 年:DQN 學打電動
- 不教規則: Google DeepMind 用同一套方法,讓程式學 Atari 2600 這台經典遊戲機上的 49 款遊戲,每款各自從頭練。給它的就是螢幕畫面和分數,不教規則,也不說每個動作是做什麼。
- 預估表: DQN 心裡像有一張預估表:看到現在的畫面,做每個動作,接下來總共大概能拿幾分。每按一下,就看這一步拿到幾分、下一個畫面又預估幾分,回頭修正。
- 試錯: 一開始它幾乎都在亂按,之後慢慢減到十次裡亂按一次,其他時候挑預估分數最高的動作。
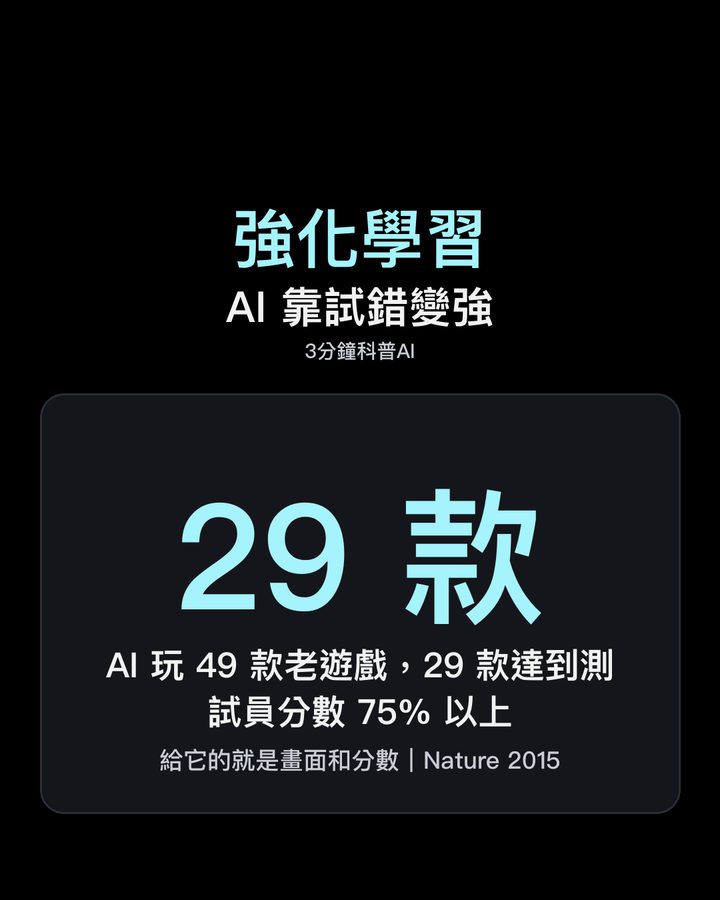
- 成績: 論文請一位專業遊戲測試員,每款練過之後玩大約 20 局算平均,也跟之前最好的方法比。49 款裡,43 款贏過之前最好的強化學習方法;29 款達到測試員分數的 75% 以上,論文把這算作人類水準。
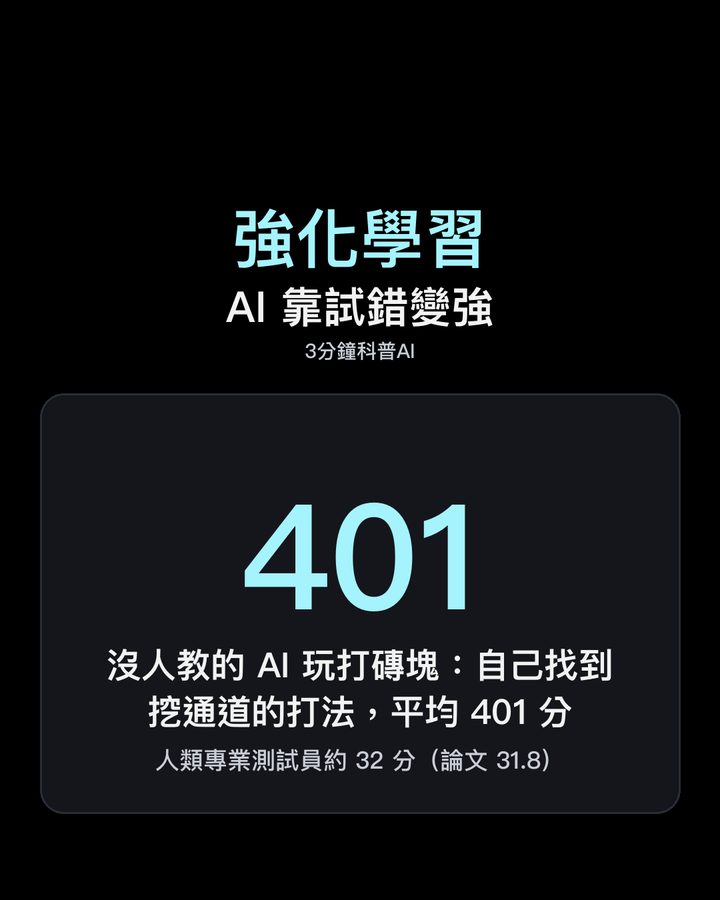
- 打磚塊: 它看到的就是畫面,回饋就是分數。它自己找到一招:先在磚牆側邊打出一條通道,讓球跑到磚塊後面來回彈。平均 401 分,測試員約 32 分(論文 31.8)。
- 學不會的: 有一款探險遊戲(《蒙特祖瑪的復仇》)要先做對很長一串動作,論文說這種需要長遠計畫的遊戲仍是很大的挑戰:亂按 0 分,DQN 也是 0 分。
2017 年:AlphaGo Zero 自己下圍棋
- 更難的棋: 打電動每一步最多 18 種動作可以選;圍棋第一步就有 361 個位置可以下。先前的 AlphaGo,先學了大量人類高手的棋譜,再自己跟自己練。
- 拿掉棋譜: AlphaGo Zero 把人類棋譜整個拿掉,給它的就是圍棋規則和棋盤上黑白子的位置,從完全亂下開始。
- 怎麼練: 每下一步之前,先在腦中往後推演 1,600 次(約 0.4 秒),挑出比較好的一步;整盤下完,輸贏就是分數,再拿推演的結果和輸贏回頭練自己。
- 結果: 練 36 小時,就超過打敗李世乭、練了好幾個月的那一版;72 小時後正式對戰,100 比 0。對戰時它用一台機器、4 顆 TPU,對手用了 48 顆。另外用一樣架構的網路改學人類棋譜,一開始比較強,但不到 24 小時就被自己練的版本超過。
用三個問題來看
- 它解決了什麼問題? 沒有標準答案、但分得出輸贏的事,AI 可以自己試出做法,不用人一步一步教;在圍棋上,還贏過學人類棋譜的版本。
- 今天的 AI 哪裡用到它? 2022 年 OpenAI 用它教 AI 好好回答問題;2025 年 DeepSeek 用它教 AI 練推理解題。
- 它有什麼限制? 要試非常多次:DQN 每款遊戲練了大約 38 天的遊戲時間,人類測試員大約 2 小時。分數要等很久才出現,就很難學;AlphaGo Zero 也要完整知道規則,才能在腦中推演。
強化學習不給答案,給分數;AI 靠大量試錯,自己找出拿高分的做法。可是,聊天沒有計分板;下一集,我們來看聊天 AI 怎麼請人當裁判。
出處
- Mnih, V., Kavukcuoglu, K., Silver, D., Rusu, A. A., Veness, J., Bellemare, M. G., Graves, A., Riedmiller, M., Fidjeland, A. K., Ostrovski, G., Petersen, S., Beattie, C., Sadik, A., Antonoglou, I., King, H., Kumaran, D., Wierstra, D., Legg, S., & Hassabis, D. (2015). Human-level control through deep reinforcement learning. Nature, 518, 529–533. https://doi.org/10.1038/nature14236
- Silver, D., Schrittwieser, J., Simonyan, K., Antonoglou, I., Huang, A., Guez, A., Hubert, T., Baker, L., Lai, M., Bolton, A., Chen, Y., Lillicrap, T., Hui, F., Sifre, L., van den Driessche, G., Graepel, T., & Hassabis, D. (2017). Mastering the game of Go without human knowledge. Nature, 550, 354–359. https://doi.org/10.1038/nature24270
- Ouyang, L., Wu, J., Jiang, X., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35, 27730–27744.
- DeepSeek-AI (Guo, D., et al.) (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645, 633–638. https://doi.org/10.1038/s41586-025-09422-z
- Ecoffet, A., Huizinga, J., Lehman, J., Stanley, K. O., & Clune, J. (2021). First return, then explore. Nature, 590, 580–586. https://doi.org/10.1038/s41586-020-03157-9
本文為論文解說,內容經過簡化,方便理解;小狗學坐下為比喻,遊戲與棋盤畫面為示意。